Lingue minoritarie,
futuro digitale.
Raccolta e strutturazione di dati linguistici per dotare ogni lingua delle fondamenta digitali che la rendano riconoscibile anche agli strumenti di intelligenza artificiale.
02 — Trascrizione
03 — Traduzione
L’intelligenza artificiale cambia le regole del gioco. Agli occhi di un modello linguistico, ogni sistema linguistico ha pari dignità: ciò che conta non è il peso della tradizione accademica, ma la disponibilità di un corpus testuale, anche non enorme. L’occitano, il bretone, il ladino, il gallese, il guaraní — possono oggi essere trattati con gli stessi strumenti usati per l’inglese o il francese, a patto di avere testi sufficienti da cui apprendere.
ALLINEATORE DI TESTI
Si parte da un archivio digitale di testi bilingui (lingua minoritaria e lingua maggioritaria) organizzati in cartelle e catalogati secondo criteri personalizzabili. I testi così archiviati costituiscono un corpus documentale, che potrà essere processato da un algoritmo di allineamento bilingue appositamente configurato per la coppia linguistica di riferimento.
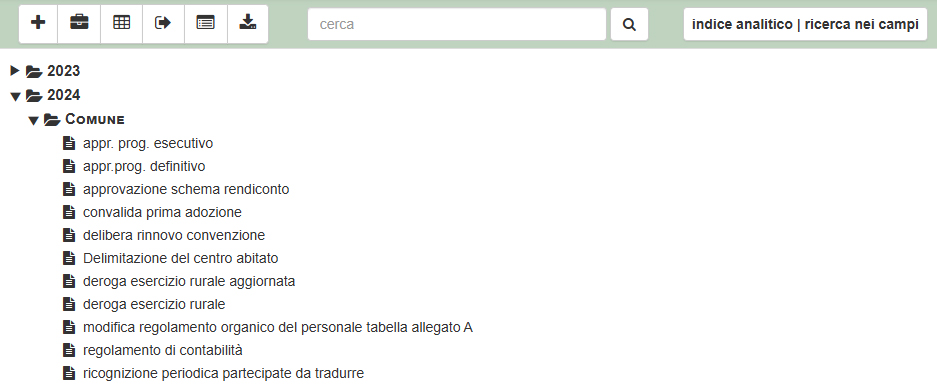
L’algoritmo analizza i testi e individua le corrispondenze traduttive a livello di segmento, costruendo in automatico una memoria di traduzione strutturata. Il risultato è un archivio allineato parola per parola, frase per frase, in cui ogni unità testuale trova la propria controparte nell’altra lingua.
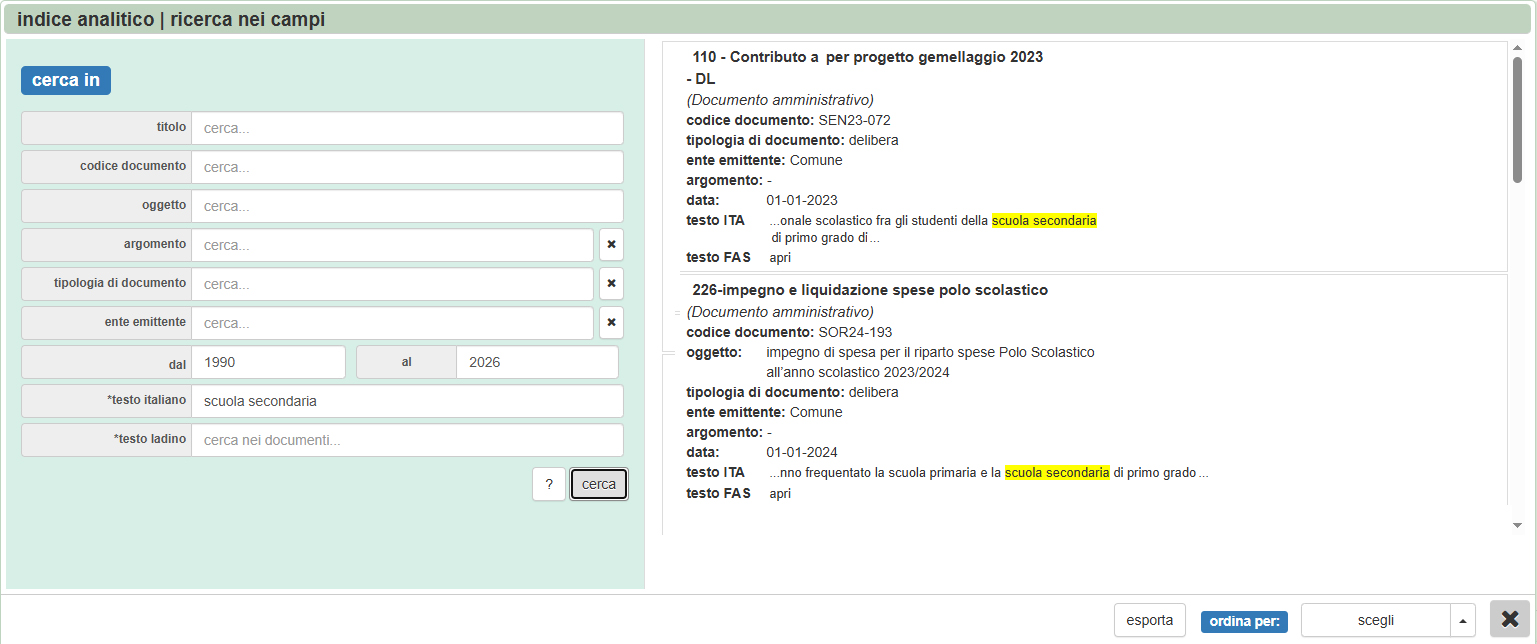
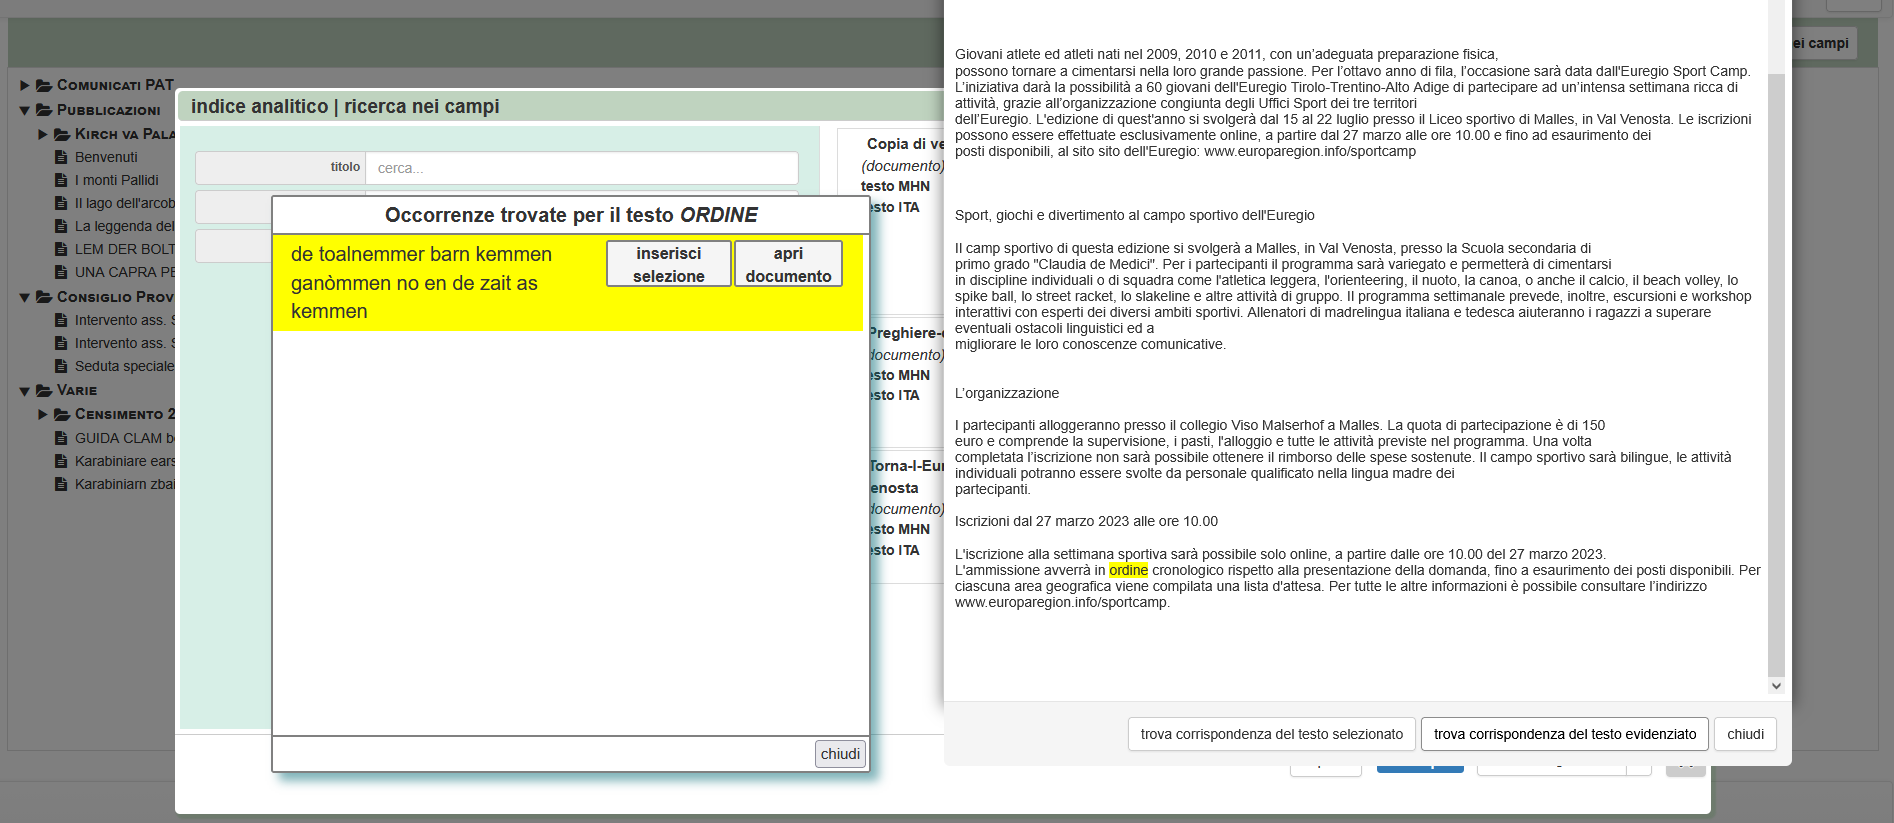
L’operatore umano potrà cercare qualunque parola o sintagma e ritrovare all’interno del corpus le occorrenze precedenti e le relative corrispondenze, sulle quali si potrà basare per le traduzioni future.
TRASCRIZIONE AUTOMATICA
Smallcodes ha sviluppato un sistema basato sull'apprendimento automatico e sulla fonetica reale, che trascrive in IPA qualsiasi registrazione audio. Il modello opera su parametri fonetici indipendenti dalla lingua — luogo e modo di articolazione, sonorità, prosodia — con approccio iterativo che affina progressivamente la qualità anche in assenza di dati preesistenti.
→
modello AI fonetico
→
output IPA
TRADUZIONE AUTOMATICA
I corpus allineati prodotti dall'Allineatore di testi e le trascrizioni generate dal modulo di Trascrizione automatica costituiscono insieme una risorsa linguistica strutturata: la materia prima su cui addestrare modelli di traduzione automatica dedicati alla coppia linguistica di riferimento.
Ciò che per le grandi lingue è dato per scontato — traduzione automatica affidabile, contestuale, aggiornata — diventa accessibile anche per le lingue minoritarie. Il modello apprende dalle corrispondenze già identificate, integra le informazioni fonetiche e testuali, e affina progressivamente la qualità con l'accumulo dei dati.
Il risultato è uno strumento di supporto calibrato sulla lingua specifica, che non sostituisce la competenza dell'operatore umano ma la potenzia, riducendo i tempi di lavoro e garantendo coerenza terminologica lungo l'intero corpus.
Come si costruisce il modello
corpus allineato (strumento 01)
trascrizioni IPA (strumento 02)
modello di traduzione calibrato sulla lingua
Allineatori disponibili
Allineatore ladino gardenese e badiotto
Allineatore fassano
Non si tratta di salvare reperti del passato,
ma di proiettare comunità vive nel futuro tecnologico.